核心信息
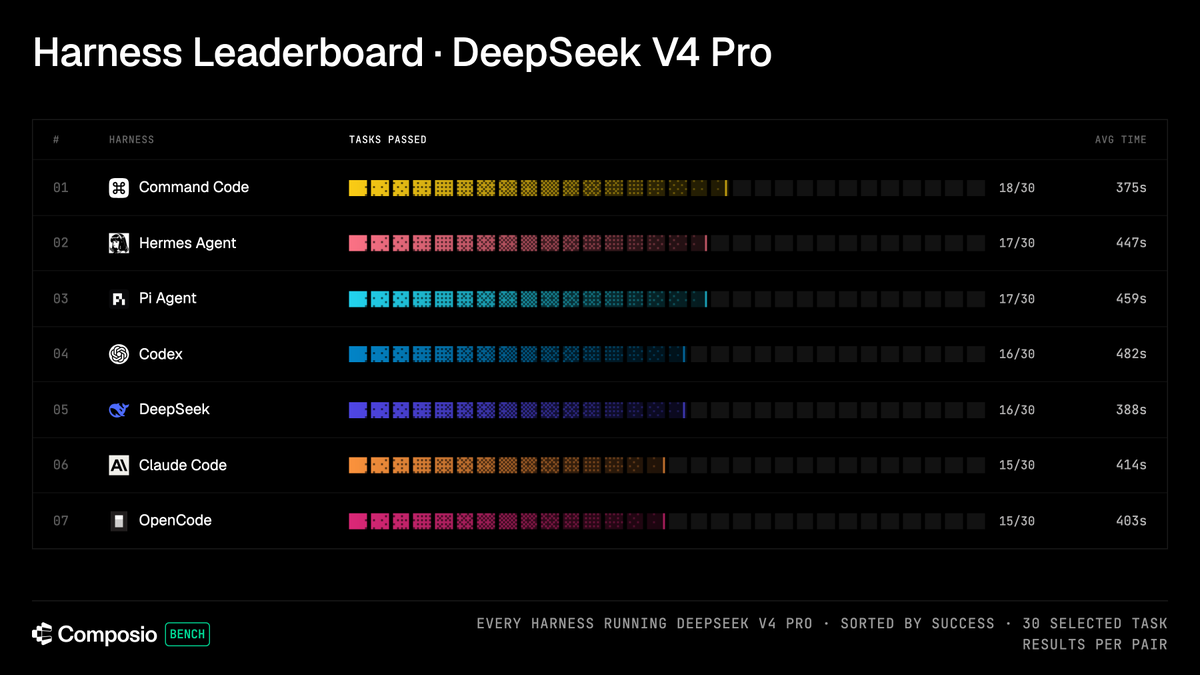
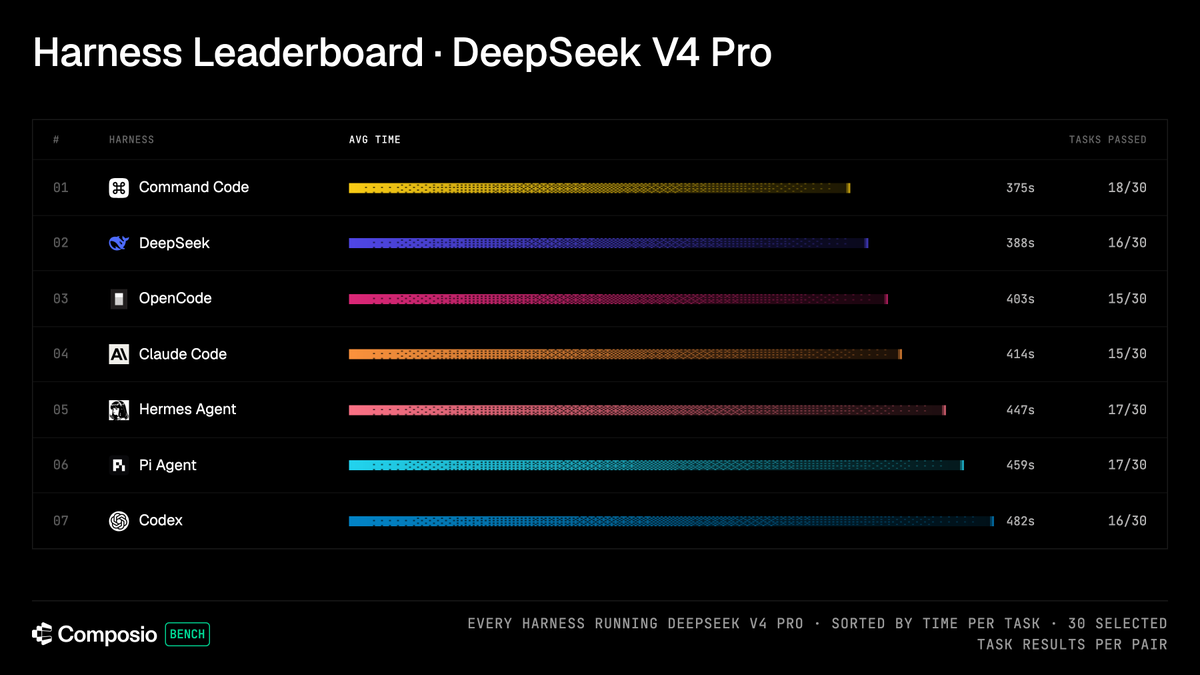
Command Code在Composio面向DeepSeek等开源模型的基准测试中表现最佳:完成30项任务中的18项,平均每项耗时375秒,速度最快,并击败了DeepSeek自家框架。Composio另一项针对GPT-6 Astra的6种智能体框架、29项任务对比显示,多数框架成功率相近,但失败时Token消耗可能增加3–5倍。
要点
- 开源模型上准确率最高:Command Code解决18/30任务,排名第一。
- 执行速度最快:平均每项任务375秒,优于其他框架。
- 超越DeepSeek原生框架:基准结果好于DeepSeek自己的harness。
- Token效率成关键:在Composio更广对比中,框架失败时的Token消耗可能高出3–5倍。