核心信息
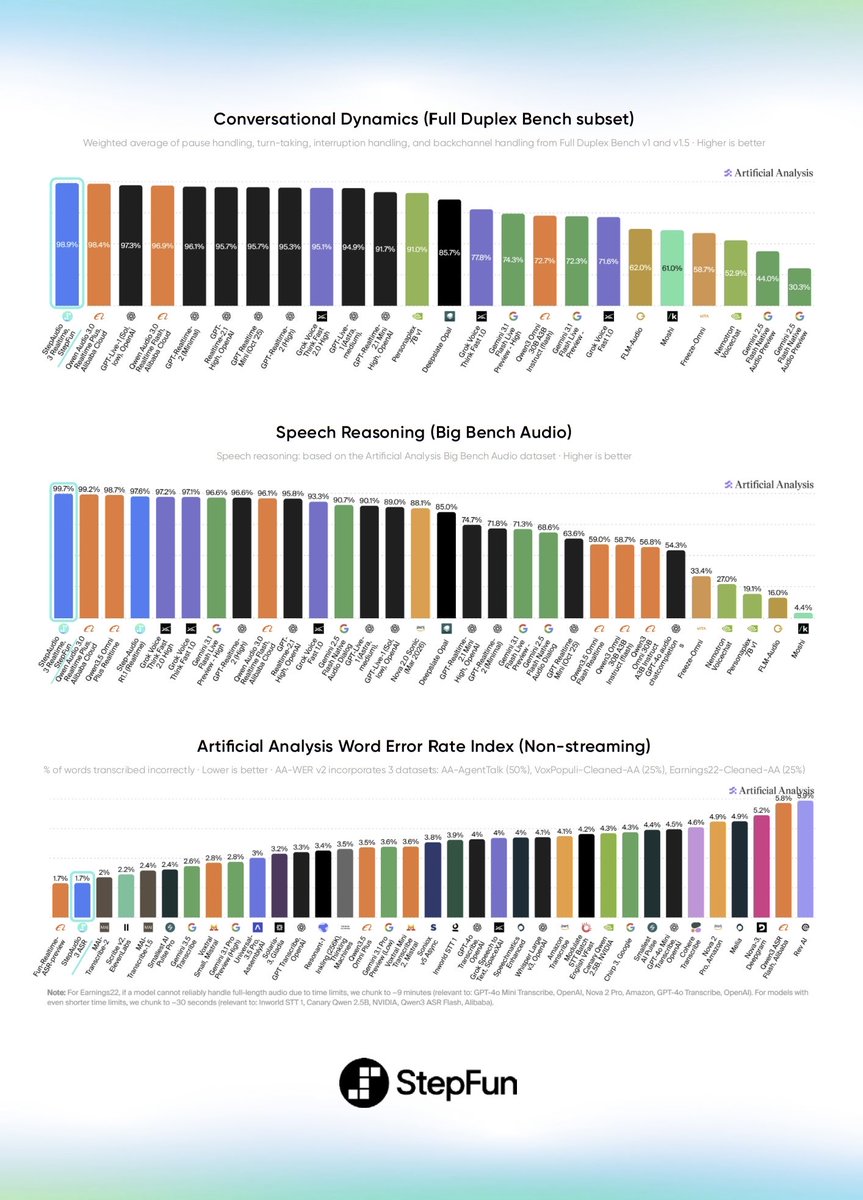
StepFun 推出 StepAudio 3,这是一个包含五个音频模型的系列,涵盖实时语音、语音识别、语音生成、音频生成与音乐。其实时语音模型在 Artificial Analysis 的对话动态与语音推理两项排名第一,语音识别词错误率低至 1.7%。
要点
- 实时语音模型在 Artificial Analysis 的对话动态(98.9%)与语音推理(99.7%)均排名第一。
- 语音识别模型达到 1.7% 词错误率,与榜单最佳成绩持平。
- 可构建支持打断、边思考边说话并能调用工具的语音智能体。
- 同时支持表现力丰富的语音生成、完整音频场景与音乐创作。