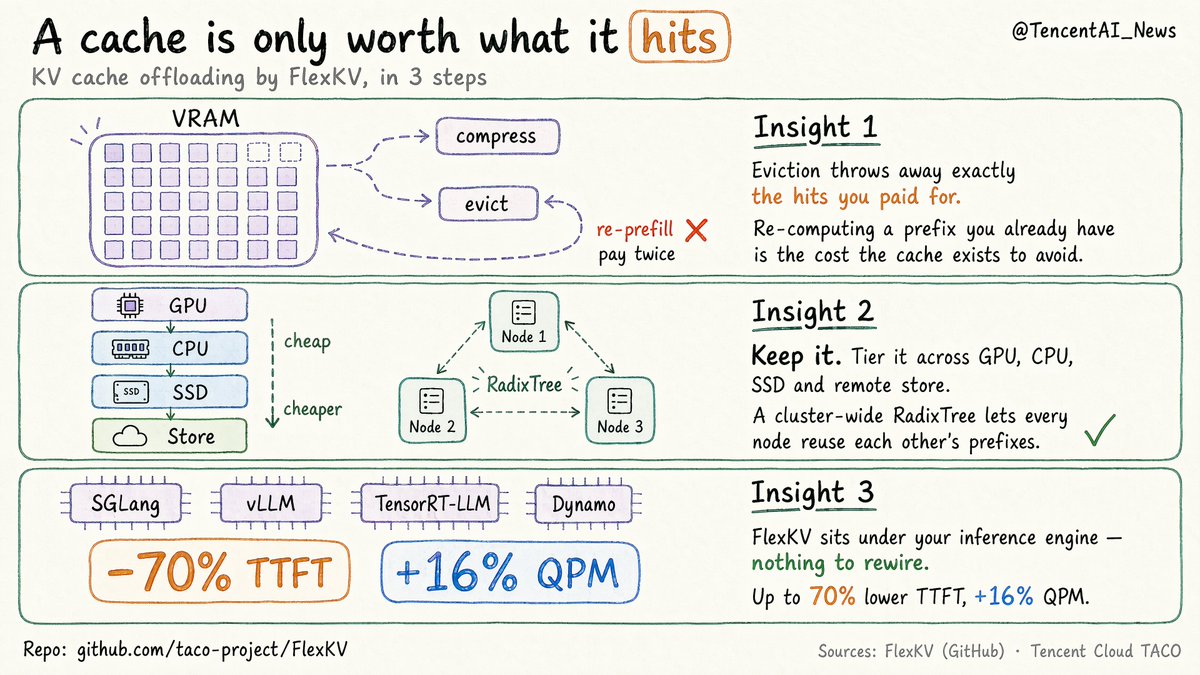
核心信息
腾讯AI的FlexKV针对长上下文推理中的瓶颈:即便KV缓存命中,从GPU外部读取缓存仍可能让GPU闲置。FlexKV采用逐层恢复方式,让计算与数据加载重叠进行。
要点
- FlexKV按层恢复KV缓存:前层计算的同时后层加载数据,减少GPU等待时间。
- 预取机制提前启动缓存传输,异步写回则让缓存I/O与推理过程重叠。
- 该工作聚焦于提升长上下文场景下“缓存命中”的实际收益,应对KV缓存规模增长带来的挑战。
腾讯AI的FlexKV针对长上下文推理中的瓶颈:即便KV缓存命中,从GPU外部读取缓存仍可能让GPU闲置。FlexKV采用逐层恢复方式,让计算与数据加载重叠进行。