核心信息
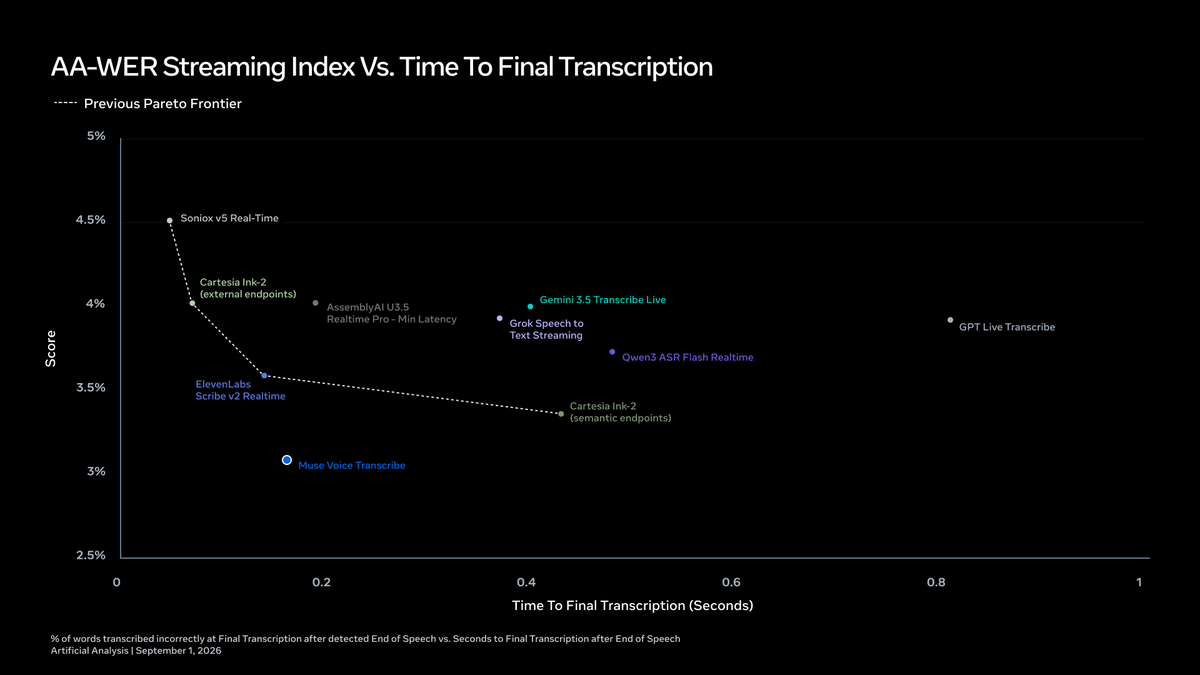
Meta Superintelligence Labs 推出了 Muse Voice Transcribe,一款面向实时流式语音识别的音频感知模型。通过自适应延迟,它在“最终转写完成时间”这一指标上达到了速度与准确率权衡的帕累托前沿。
要点
- Muse Voice Transcribe 被称为 Meta Superintelligence Labs 的首个实时音频感知模型。
- 支持实时流式 ASR,并可对 20 多位说话人进行说话人分离(diarization)。
- 自适应延迟机制让模型在速度与准确率之间取得帕累托最优平衡。
- 评估指标为最终转写完成时间(time to final transcription)。