核心信息
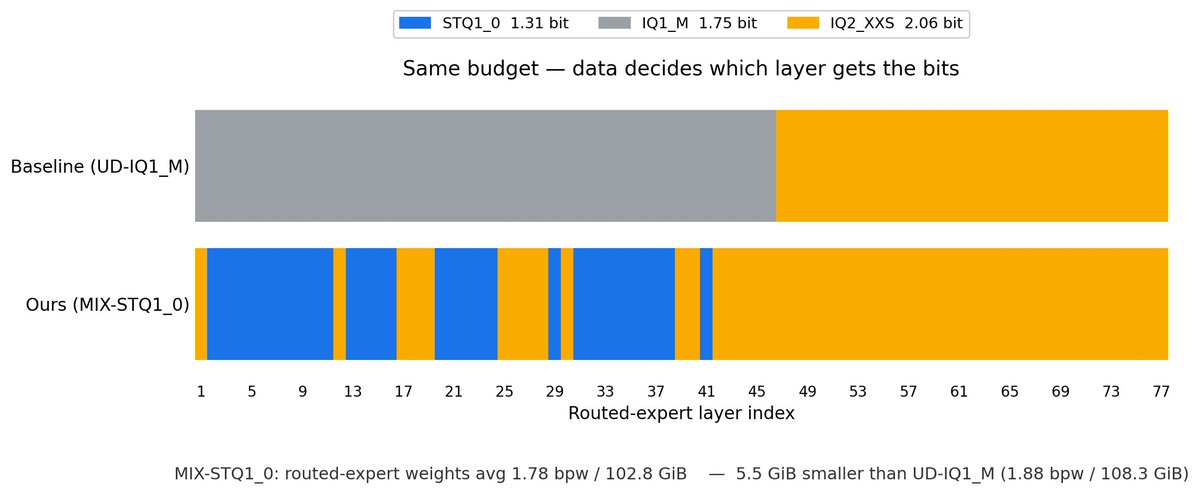
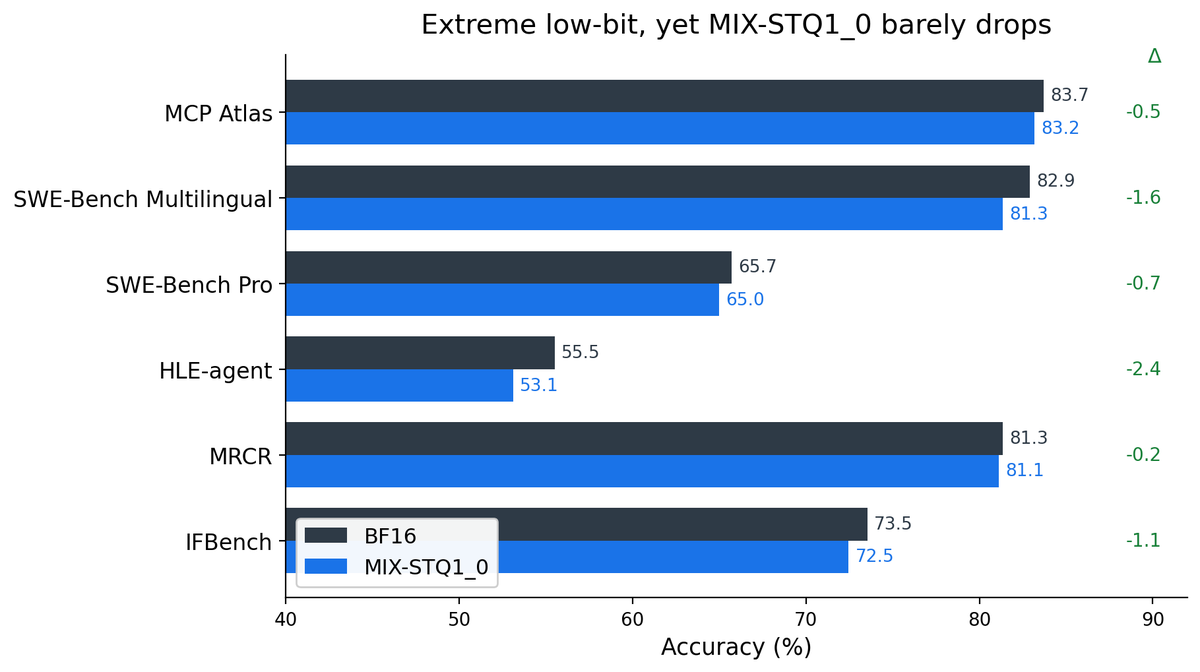
AngelSlim 发布了 Hy4-preview 的 GGUF 量化版本,通过逐层混合精度量化(STQ1_0 与 IQ2_XXS)将模型从 1.5TB 压缩至约 200GiB,精度损失极小。
要点
- 关键不是一味降低位宽,而是依据校准数据为每一层选择合适位宽:部分层低至 1.31-bit STQ1_0,部分层使用 2.06-bit IQ2_XXS。
- 与 BF16 相比精度几乎不变:MCP Atlas 83.7→83.2,SWE-Bench multi 82.9→81.3,MRCR 81.3→81.1,IFBench 73.5→72.5。
- 权重与低比特 GGUF 已发布在 Hugging Face:AngelSlim/Hy4-preview-GGUF。